2023年4月21日金曜日

2023立て看コレクション

立て看板,それは青春の象徴.大学にタテカンはつきもの,ということで,今年の面白タテカンを紹介したい.採取した場所は東京大学の駒場キャンパスである.さすが東大生というべきか,ユニークなタテカンがいくつも展示?されていた.これは!と思ったタテカンを紹介しよう.

まずはこれ.シンプルなタテカンだが,これは「STOP! UNDER20 DRINKING」のパロディですね.酒でも飲まんと聞いてられん,あるある.

アイデア:★★★★
技術:★
インパクト:★★★

続いて,これは管弦楽団の入団募集タテカン.写真だと分かりにくいかもしれないが,これ,造形がとてもうまい.全てのデザインが立体造形されていて,手が凝っている.中央のバイオリンも美しい.そしてすごく地味なのだが右下のQRコードも木彫りなのだ.

アイデア:★★
技術:★★★★★
インパクト:★

技術が光るといえばこれも興味深い.劇団のタテカンである.大道具さんの面目躍如といったところか,っていうかこれタテカンなのか?

アイデア:★★
技術:★★★★★
インパクト:★★★

番外編.なんで早稲田の冒険部が駒場にタテカン出してるの?冒険心まる出しだなあ.さすが冒険部.

アイデア:ー
技術:ー
インパクト:ー

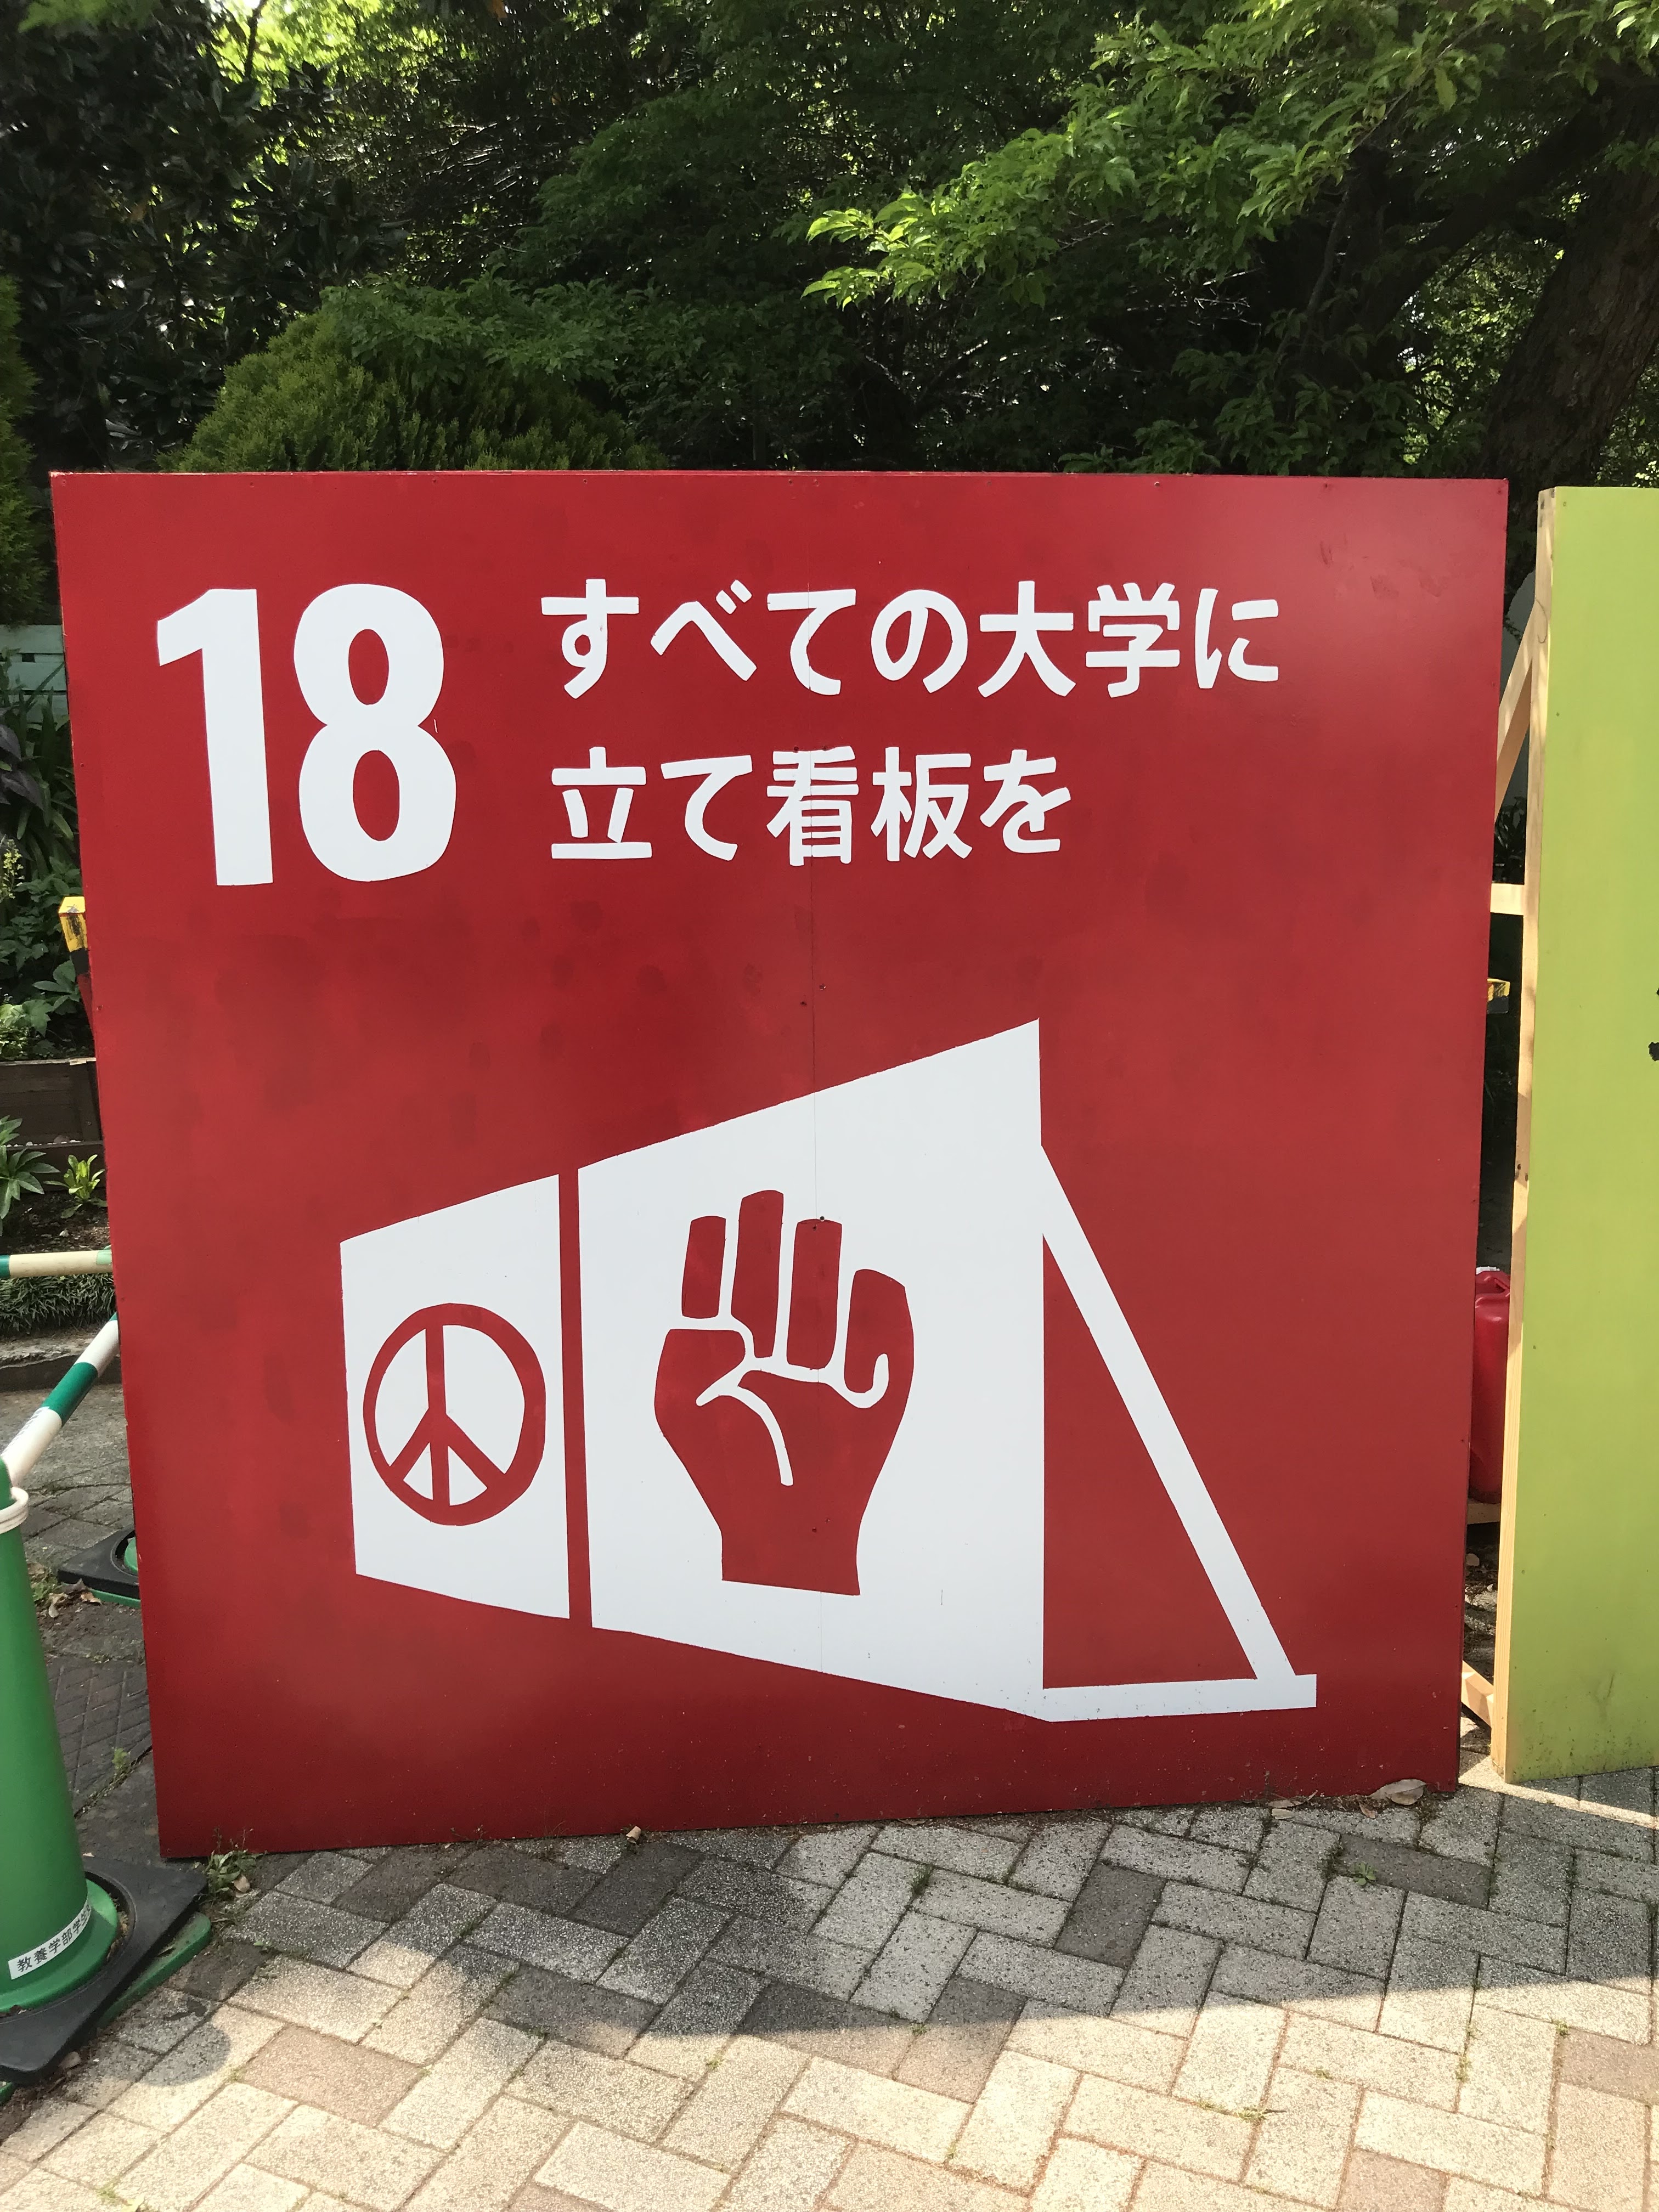
今年いちばん優秀だと思ったのがこれ.SDGsのパロディである.蛇足ながら解説すると,17個あるSDGsの項目に18番目としてタテカンの自由を追加せよ,というもの.東大だったのが惜しい.このタテカンこそ京大構内に設置してほしかった.

アイデア:★★★★★
技術:★★★
インパクト:★★★★

おまけ.新入生代表による感謝のタテカンである.こうやってタテカン文化が継承されていくのか.でも,これ本当に新入生が立てたタテカンなのかなあ?w

アイデア:ー
技術:ー
インパクト:ー


2023年4月20日木曜日

ChatGPT記事への反応を定量分析

 2ヶ月ほど前の話なのだが「ChatGPTでプログラマはお払い箱になるのか」という記事を書いたところ,珍しくバズり,いつもの数十倍以上のアクセスがあった.はてブのホッテントリにも載ったので,ブコメが100件近く(正確にいうと94件)ついた.

最近,学生がわりと高性能な日本語センチメント分析器(感情分析器)を見つけてきたので,ちょっとした手遊びとして,94件のブコメをざっとスクレイピングして分析器にかけてみた.っていうか,「人々はエシカル消費をどう捉えているか」で紹介した,学生がやっているエシカル消費に関する研究で作ったスクリプトを援用してみた,というわけである.

分析結果

さて,結果はどうなったか.

センチメント分析

まず,94件の内訳を紹介する.ポジティブが18件,ネガティブが29件,ニュートラルが47件となった.ここでは,ポジティブは肯定派,ネガティブは否定派,ニュートラルは中立派ととらえておこう.ポジティブが最も少ない結果となったが,まあ,記事の内容そのものが,プログラマを代替することはないのでは?という否定的なものだったせいか.

次に,それぞれのコメントをポジティブ群,ネガティブ群,ニュートラル群に分けて,簡単なテキスト分析をしてみた.ここではポジティブおよびネガティブ群の結果を紹介する.

ワードクラウド

グループに分けたコメントからワードクラウドを作成してみた.ワードクラウドは,文章中に現れる単語群を,その出現頻度の高さに応じて単語の大きさを大小させることで,どんな言葉が使われているかを視覚的に表す可視化手法である.

以下に紹介するのは,コメントを形態素解析し,名詞,動詞,形容詞などを抽出したものに基づいて作成したワードクラウドである.なお名詞に関しては,連続して出現する名詞は一つの名詞として繋げる,いわゆる「名詞の連接処理」を加えている.

ポジティブ群から紹介しよう.「プログラマ,AI,書く,くれる」というキーワードが大きく示されている.AIがプログラマの代わりに書いてくれる,というようなコメントが目立ったということか.実際,18件のコメントを眺めてみると,AIがプログラムを書いてくれるのでプログラマは楽をできるとか,使い方を工夫すれば十分に使えるなど,そのようなコメントが並んでいる.

次はネガティブ群のそれである.

「chatbot,お払い箱,人,AI,自分」という単語が大きく表示されている.これはどう解釈すべきだろうか.残念ながら,このワードクラウドから引き出せる情報は少ない.ネガティブ群29件のコメントを全部眺めてみると,その多くは「いやお払い箱にはならんやろ?」というものである.このセンチメント分析器の精度はけっこう高いなあと感心した.

共起ネットワーク図

同じような分析ではあるが,共起ネットワーク分析もやってみた.共起ネットワーク図とは,やはり単語の出現頻度でその大きなものを大きなノードとして表し,さらに,同じ段落のなかに入っている(これを「共起」という)頻度が高いものはエッジで結ぶ,その結果をグラフとして表すというものである.なお,ここでいうグラフとは,皆さんお馴染みの棒グラフや折れ線グラフというグラフではなく,数学のグラフ理論でいうところのグラフ,ノードと呼ばれる点や丸で表された図形を,エッジと呼ぶ線で繋いだ図のことである.

こちらも,ポジティブ群から紹介しよう.

対象とするデータのサンプルサイズが小さいので,いささかシンプルなグラフになっているのはご容赦いただきたい.「プログラマは他にやることができる」(右下)とか,「うまいこと使って作業効率を上げる」(上)とか,そのような話題が見出せる.

ネガティブ群はどうか.

「chatgptは嘘をつく」「セキュリティ的に無理」というような共起関係(中心あたり)が目に付く.右上の「正しい,使える,出る」という単語群は,一見,肯定的な意見のようにもみえるが,元データに立ち戻って確認してみると,「出てきたものが正しいが判定できないと使えない」とか「正しさが保証できるコードが出ないと使えない」とか,そのようなものであった.

2023年4月19日水曜日

人々はエシカル消費をどう捉えているか

「エシカル消費」という概念をご存知だろうか.倫理的消費ともいい,倫理的に適切な消費行動かどうかという概念である.具体的には,フェアトレード(発展途上国との公正な取引)とか,フードロス(食品廃棄)の削減,再生エネルギー,地産地消などである.身近なところではマイバックとかリサイクルとか,節電や節水などもその範疇に入るだろう.

市井の人々はエシカル消費に関してどのような態度をとっているのだろうか.皆さんはどうですか?飯尾ゼミのメンバーで,それに着目して分析を進めた2年生(現3年生)のグループがいて,ちょっと面白い結果が出たので(一部だけ)ここで紹介したい.

彼ら彼女らの興味は,エシカル消費およびその具体的なテーマに関して,Twitterではどんなツイートがなされているのだろうか,というものである.さらに,収集したツイートに対してセンチメント分析(感情分析)を行い,ポジティブなツイート群の特徴や,ネガティブなツイート群の特徴を調べた.

ここではその一部を紹介する.次の図は,ネガティブ群のデータに基づいて作成した共起ネットワーク図である.

いくつか面白いトピックが現れているが,注目すべきは右下の「紙ストロー」を中心とするクラスタであろう.この「紙ストロー」,とにかく評判が悪い.ネガティブ感満載である.ポジティブ群にもいくつか現れているが,そのほとんどが「料理が美味しかった!ただ,紙ストローがねぇ……」というようなものである.

さて,研究の具体的な方法や,他の分析結果については,6月の春季HCD研究発表会で,学生が発表予定である.乞うご期待!

2023年4月18日火曜日

iDS演習第2回のソースコード

データの導入

import pandas as pd
df0 = pd.read_excel('ethical_tweets_original.xlsx')
df0 = df0.drop(df0['Unnamed: 0'], axis=1)
df0

リツイートと広告ツイートの排除

df1 = df0.drop(df0[df0['retweet']].index)
df2 = df1.drop(df1[df1['advertise']].index)
df2

キーワードとツイート内容の列だけのデータフレームにする

df3 = df2[['keyword', 'tweet']]
df3

{ キーワード,ツイート内容 } の dict に変換する

tweets = df3.to_dict(orient='records')
tweets

センチメント分析の下準備(1)

!pip install transformers
!pip install transformers['ja']
!pip install sentencepiece
!pip install ipadic

センチメント分析の下準備(2)

from transformers import pipeline, AutoModelForSequenceClassification
from transformers import BertJapaneseTokenizer, BertTokenizer, BertForSequenceClassification

# パイプラインの準備
model = AutoModelForSequenceClassification.from_pretrained('koheiduck/bert-japanese-finetuned-sentiment')
tokenizer = BertJapaneseTokenizer.from_pretrained('cl-tohoku/bert-base-japanese-whole-word-masking')
classifier = pipeline("sentiment-analysis",model=model,tokenizer=tokenizer)

センチメント分析をして極性とスコアを返す関数を定義し,取得したツイートに適用する

def classify(tw):
result = classifier(tw)[0]
return (result['label'], round(result['score'], 4))

col_names = ['label','score','keyword','tweet']
df = pd.DataFrame(columns=col_names)

for tw in tweets:
(label, score) = classify(tw['tweet'])
new_row = pd.DataFrame([[label,score,tw['keyword'],tw['tweet']]],
columns=col_names)
df = pd.concat([df,new_row],axis=0)

df

インデクスが全部0でおかしいので,それを修正

df = df.reset_index().drop('index', axis=1)
df

簡単なテキストマイニングをしてみる.その準備(1)

#GiNZAのインストール
!pip install ginza
!pip install ja_ginza

#Matplotlib日本語化のインストール
!pip install japanize-matplotlib

#GraphViz関連のインストール
!apt install libgraphviz-dev
!pip install pygraphviz

#日本語フォントのインストール
!apt-get -y install fonts-ipafont-gothic
!rm ~/.cache/matplotlib/fontlist-v310.json

簡単なテキストマイニングをしてみる.その準備(2)

import pandas as pd
import spacy
import ginza
import math
import matplotlib.pyplot as plt
from itertools import combinations, dropwhile
from collections import Counter, OrderedDict
import numpy as np
from networkx.drawing import nx_agraph
import networkx as nx
import japanize_matplotlib

STOPWORDS = ['\n', 'o', '\u3000', '\n\u3000','\u3000\n',
'お','す','り','ご','いる','ある','ない','こと',
'なる','ござる','する','いう','言う','思う']

nlp = spacy.load('ja_ginza')
ginza.set_split_mode(nlp, 'C')

@によるメンションを削除する関数を定義

def remove_at_mention(text):
words = text.split()
return ' '.join([ x for x in words if x[0] != '@' ])

単語を抽出する関数の定義

def extract(s):
text = list(s)[0]
text = remove_at_mention(text) # @xxx... を取り除く
doc = nlp(text)
retvar = []
for sent in doc.sents:
noun = ''
for token in sent:
if token.lemma_ in STOPWORDS: continue
if token.pos_ in ['NOUN', 'PROPN', 'NUM']:
noun = noun + token.lemma_
elif noun != '':
retvar.append(noun)
noun = ''
if token.pos_ in ['ADJ', 'INTJ', 'ADV', 'VERB']:
retvar.append(token.lemma_)
if len(noun) > 0: retvar.append(noun)
return retvar

単語に分割した結果を新たな列として追加されたデータフレームを作成

df['words'] = df[['tweet']].apply(extract, axis=1)
df

共起ネットワーク図を書くコードの定義

def conet(df, outfile, min_count=3, edge_th=0.12):
# jaccard係数を計算する(回答の単語登場数:3以上、jaccard係数:0.12以上)
jaccard_coef = []
pair_all = []

words_array = [ set(x) for x in list(df['words']) ]
for chunk in words_array:
tmp_pair = list(combinations(chunk, 2))
for i, pair in enumerate(tmp_pair): tmp_pair[i] = tuple(sorted(pair))
pair_all += tmp_pair
pair_count = {x: count for x, count in Counter(pair_all).items() if count >= min_count}

word_count = Counter()
for chunk in words_array: word_count += Counter(chunk)
for pair, count in pair_count.items():
jaccard_coef.append(count / (word_count[pair[0]] + word_count[pair[1]] - count))
jaccard_dict = OrderedDict()
for (pair, count), coef in zip(pair_count.items(), jaccard_coef):
if coef >= edge_th: jaccard_dict[pair] = coef

# グラフの描画
G = nx.Graph()
G.add_nodes_from(sorted(set([j for pair in jaccard_dict.keys() for j in pair])))
for pair, coef in jaccard_dict.items(): G.add_edge(pair[0], pair[1], weight=coef)

plt.figure(figsize=(15, 15))
seed = 0
np.random.seed(seed)
pos = nx_agraph.graphviz_layout(G, prog='neato',
args='-Goverlap="scalexy" -Gsep="+6" -Gnodesep=0.8 -Gsplines="polyline" -GpackMode="graph" -Gstart={}'.format(seed))

values = nx.pagerank(G).values()
nx.draw_networkx_nodes(G, pos, node_color=list(values), cmap=plt.cm.terrain, alpha=1.0, node_size=[100000*v for v in values],
edgecolors='black')
nx.draw_networkx_labels(G, pos, font_family='IPAexGothic', font_size=24)
nx.draw_networkx_edges(G, pos, alpha=0.7, edge_color='black', width=[d['weight'] * 8 for (u, v, d) in G.edges(data=True)])

plt.axis('off')
plt.tight_layout()
plt.savefig(outfile, bbox_inches='tight')

クラス分けする

df_nega = df[df['label'] == 'NEGATIVE']
df_posi = df[df['label'] == 'POSITIVE']
df_neut = df[df['label'] == 'NEUTRAL']

共起ネットワーク図を描く(ネガティブ群)

conet(df_nega, 'nega.png')

共起ネットワーク図を描く(ポジティブ群)

conet(df_posi, 'posi.png')

ワードクラウドを作ってみる

import wordcloud

path_to_font='/usr/share/fonts/truetype/fonts-japanese-gothic.ttf'

def mk_wc(word_array):
wc = wordcloud.WordCloud(width=1000, height=600,
background_color='white', font_path=path_to_font)
wc.generate(' '.join(word_array))
plt.imshow(wc)
plt.axis('off')

import itertools

def mk_wc_from_df(df):
mk_wc(list(itertools.chain.from_iterable(df['words'])))

ワードクラウドを描く(ネガティブ群)

mk_wc_from_df(df_nega)

ワードクラウドを描く(ポジティブ群)

mk_wc_from_df(df_posi)

2023年4月11日火曜日

ネットメディアとマスメディアの蜜月について

電子情報通信学会の英文論文誌,IEICE Trans. Info. & Sys. の4月号に,次の論文が採録されている(オープンアクセスなので,興味がある方はリンクをクリックすれば本文を読めます).

Iio, J., (2023). How Many Tweets Describe the Topics on TV Programs: An Investigation on the Relation between Twitter and Mass Media, IEICE Transactions on Information and Systems. E106.D(4), 443-449.

この論文は「ツイッターで人々が話題にしているトピックにはTV関連の話題が多く含まれている」ということを定量的に示したものである.具体的には「ツイッターのトレンドに現れるトピックのおよそ20〜25%はTV関連のトピックである」ということを,TWtrendsシステム(Iio, 2019)のデータとEPG(電子番組表)のデータを付き合わせて明らかにしたものだ.

論文は「(The result of this study) implies codependency between Internet media and mass media.(本研究の結果から,ネットメディア(ソーシャルメディア)とマスメディアの共依存が認められる)」と結ばれている.しかし,実際には,SNS側からのマスメディア依存度は定量的に示したものの,マスメディアがネットにどれだけ依存しているかは論文では明示的には示していない.

しかし,昨今のマスメディア,とくにTVの報道番組やワイドショーなどを見ていると,ネット依存であることは明らかであろう.その証拠がこれである.

Twitterで「突然のご連絡 テレビ」などとキーワードを入れて検索すると,出るわ出るわ.「突然のご連絡 ラジオ」や「突然のご連絡 新聞」などでもたくさん出てくる.

いやはや,まあ「突然のご連絡」するな,とはいわないが,それを契機に自分たちでさらに取材,深掘りするならともかく,その後,視聴者ご提供の動画などといって垂れ流して終わりというケースが散見されるのはいかがなものか.いささか安易な番組作りをしていないか?と苦言も呈したくなる.まあ,余計なお世話か.

参考文献

Iio, J., (2019). TWtrends ― A Visualization System on Topic Maps Extracted from Twitter Trends, IADIS International Journal on WWW/Internet, 17(2), 104-118

2023年4月10日月曜日

iDS演習成果発表会2023・冒頭挨拶の書き起こし

みなさん,おはようございます.これ,中継しているんですよね,録画してるんですか……,してる.はい,わかりました.じゃあ,あまり変なことは喋れませんね(会場笑).

まあ,いまのは冗談ですが,はえある第1回の成果報告会ということで,会場も,素晴らしいところで,天気ももう,雲ひとつないいい天気ですね.本当に,恵まれた,成果発表会になったと思います.

10分間挨拶をせよ,ということで私もどうしたものかと,最近流行りのChatGPTに相談してみました.ということで,普段,私はこういうあんちょこを見ながら挨拶することはないんですが,今日は特別で,ChatGPTに,「AIデータサイエンス演習(iDS演習)で10分間の挨拶をしなければなりません.挨拶文を考えてください」という相談をしてみました.ちょっと読み上げますね.彼,彼女ですか?ChatGPTの答えは次のようなものでした.

だそうです.すごいですよね.もう,なんか,私が考える挨拶文なんかよりはるかにすばらしい文章が綴られていました.ただ,たいへん残念なことにですね,私が読み上げた長さは3分くらいなので,「10分間の挨拶をお願いします」とお願いしたのにこれで終わってしまうというのは,もう少し頑張ってほしかったと思う次第です.

まあ,いずれにしてもですね,ChatGPT,これ,皆さん人工知能で,AIの応用ということで,いま,すごくもてはやされていますが,私の考える,私見ではありますが,あれはたんなる道具であってですね,そこに人格を見出してどうのこうのという話は,ちょっと違うのかな,まあ,そのへんの話は,このあと,皆さんの発表が終わったあとの,教員のトークセッションでもう少し深くご紹介したいと思いますが,そういうようなことを考えています.皆さんも,そういうことを理解できるように,勉強を進めていただきたいと願うところです.

それで,あとはChatGPTにばっかり頼っていてもしょうがないので,私の言葉で補足いたしますと,いくつか補足することがございます.

まず,この会場,素敵な会場ですね,先ほど樫山先生にお伺いしたところ,こけらおとしのイベントだということで,我々としても大変嬉しく存じます.この素敵な会場を使わせていただいたことに御礼申し上げます.

それから,順不同にいきますと,今回は新3年生,2年生の発表ですので,外部からご参加されている皆様は,そこはお手柔らかにということで,まだ2年生,そして,3年,4年とあと2年間,勉強を続けていきますので,そこは割り引いて,暖かく見守っていただければと思います.

あと,実行委員会の皆さんですね.実行委員会の皆さんが,精力的に準備を進めてくださって,今日のこの時間に至っています.本当に感謝します.ありがとうございます.

また,挨拶というか注意事項です.皆さんにお願いがございます.私のゼミではいつも言っていることですが,こういう発表会というのは,発表する人が,わーっと発表して終わり,ではありません.発表する人が,なぜ発表するのか,そして,皆さんはなぜそれを聞くのか.

それはですね,発表する人と聞いている人の,コミュニケーションの場である,ということをきちんと考えてくださいということです.すなわち,発表に対して,聞いている皆さんは真摯に聞いて,かつ,その内容について,わからないことがあったらきちんとメモをとる,そして,どんどん突っ込んであげる.そのあとの発表のあとはQ&Aのセッションがありますから,どんどん質問を出してください.質問じゃなくて感想とかコメント,何でもいいですね.一方的に発表するだけでは発表会の意味がありませんので,聞いている人たちはどんどん質問をしてください.

さっき,今井さんの説明 ※1 のあとで,えーとなんだっけ,沖縄だか九州だか,「確実に行けるにはどうしたらいいんですか?」という質問が出るかなと期待していたんですが,誰も質問してない.そういう,発表する人たちは丁寧に発表する,それから,聞いている人たちは,きちんと質問をして,活発な質疑応答で盛り上がる,まあ,これは日本人があまり得意としないところではありますけれども,これからはグローバルな社会ですので,ぜひですね,そういうスキルも身につけて,どんどんと成長していっていただきたい,というふうに思う次第です.

だいたい10分間になりましたかね ※2,ちょっと時計をみていないのですが……,まあ,じゅうぶん喋ったと思いますので,このへんで,冒頭の挨拶を終わりといたします.今日一日,楽しんでやりましょう!


※1 開催前のアナウンスで,沖縄や九州にインターンシップに行けるという説明があった

※2 10分に届かず.7分強のスピーチでした orz

2023年4月7日金曜日

チューリングテストをパスしたChatGPT

人工知能に関するトピックの一つに「チューリングテスト」というものがある.ITmediaのAI・機械学習の用語辞典からその解説を引用する.

チューリングテスト(Turing test)とは,機械(=人工知能)の能力が,人間が行う「知的活動」と同等,もしくはそれと区別がつかないほどであるかを確かめるためのテストである.もっと簡単にいうと,機械(=人工知能)が人間の模倣をして,それに人間が気付かないかどうかをテストすることだ.

具体的には,壁の向こう側に置かれた応答機械もしくは人間に対して質問を投げかけ,それが人間なのか機械なのか区別つかないような返答が戻ってきたとき,それが機械による反応であればそれを人工知能と認めよう,というものである.

揶揄ってゴメン

ところで,ChatGPTは大規模言語モデル(LLM)を用いた文章生成マシンであり,確率的に最も「それっぽい」文章を作成する機械である.したがって,意味的に正しくない回答を出力する可能性はある,と,本家からも断り書きが出ている.

しかし,人工知能と銘打って世間に広まっているため「なんでも正しく答えてくれる機械」と誤解が浸透している.そこに警鐘をならすべく(という建前で)私は彼(彼女?)の珍回答をいくつか紹介している.いや,まあ,本音をいえば,たんに面白がっているだけだけど.

たとえばこれ.

中大兄皇子の隠し子が平家の源流になっているなんて話は聞いたことがない.私が,思いつきで勝手にでっち上げたフレーズである.しかし,ChatGPTはしれっと,息を吐くようにデタラメを並べる.

意地悪な私は,さらに畳み掛けてみた.

もはや支離滅裂である.いったん嘘をつき始めるともう退けなくなっちゃって,ニッチもサッチもいかなくなるという人間のありがちなサガを超えた,これもひとつのシンギュラリティ?なんて思っちゃうくらいだもの.

まあ,それにしてもうまいこと文章を作るものだと,その点は感心する.

怒る人がいる

ところがである.こういうことをして遊んでいると,それに対して怒る人が現れた.こういう遊びはけしからんだとか,新技術を否定するのはよくないだとか,まあ,そんな感じ.「ChatGPTから期待通りの回答が返ってこないことによってChatGPTは馬鹿だっていうのはどうなのか?」というご批判もいただいた.

私も「馬鹿」という言葉遣いはあまりよくないかなと反省するところではあるが,機械であることを認識しているからこそ,多少,乱暴な言葉を使うのである.そもそも,ChatGPTを開発している皆さんは素晴らしいとリスペクトしているし,彼らが馬鹿であろうはずがない.

それゆえに,こういう上手な使い方もあるよという紹介もしている.

人格をうっすら認めているのでは?

新技術を否定するのはよくない(別に全否定しているわけじゃないんだけど……)というご批判はともかく,馬鹿といっちゃイカンだの,揶揄ったらイカンだの,なぜそのようなご批判を受けるのだろう?と考えていたら,どうも皆さん,無意識のうちにChatGPTに人格を認めているのではなかろうか,という結論に至った.

そう考えると,けしからんというのも納得がいくのである.かくいう私も,機械だと分かってはいながらも,いくつかの記事で「誤り上手」だの「頑固者」だの,人格を想定しているような表現で扱っていた(次図).

すなわち,はからずもChatGPTはチューリングテストを既にパスしているのではと考えられるのである.

ちょっとググってみたら,「音声検索とマーケティング|SiriやAlexaは家族の一員になれるか」なんて記事も見つけた.家族の一員ですよ!チューリングテストなんて,もう,はるか昔の考え方なのかと思ってしまうほどである.いやはや,たいへんな時代になったものだ.

2023年4月5日水曜日

プログラマの皆さん向け「ChatGPTの上手な使い方」

ChatGPTは抽象的な質問をすると抽象的な回答しか答えてこないし,そもそもその原理からして固有名詞に弱いという指摘もある.プログラムをスクラッチから書いてとお願いしても,結局のところ仕様を細かくくどくどしいまでに記述しなければならないので,そのような使い方はあまり効果的ではないという話は,以前にも「ChatGPTでプログラマはお払い箱になるのか」で示したとおりである.

だが,次のような使い方はとても効果的だ.

「pandasのDataFrameから特定の文字列を含むレコードを取り出すにはどうしたらよいか知りたい」という状況を考えてみよう.うまくできることは知っているが,久しぶりにDataFrame弄ったので,具体的なやり方を忘れてしまった,という状況である(実は,実際に昨日,学生といろいろ作業していてこのような場面に直面した).

そのまま,ChatGPTに聞いてみた.なお,英語で尋ねているのは,そのほうが正確な答えがくるのかな?と考えただけなので,たぶん日本語でも大丈夫だろう.

Cirtainly! などと得意げに答えてきたChatGPT,はてさてこのコードが正しく動作するか,Google Colaboratoryに突っ込んで試してみよう.Copy codeボタンでコピーし,Colabのコードセグメントにペーストして実行するだけである.

たしかにきちんとできている.ブラボー.ここまで3分かからない.このようなアシスタント的使い方は効果的だろう.なお,ChatGPTは間違ったコードもしれっと吐くので,きちんと確かめるというプロセスは重要である.鵜呑みにしないようにね!

2023年3月31日金曜日

ChatGPTは謝り上手?

難癖つけてくる奴にはとにかく謝っとけ,みたいなプログラムになっているんだろうなあ.見倣うところはあるかもしれない,……ないな


私:どうしてChatGPTは馬鹿なのか

ChatGPT:私たちは、ChatGPTを知的であると信じています。 ChatGPTは、自然言語処理の分野で高度な人工知能技術を使用して構築された、大規模な言語モデルです。このモデルは、世界中のさまざまなドメインの大量のテキストデータを学習し、言語に関する広範な知識を習得しています。ChatGPTは、継続的に学習を続けており、常に進化し続けるため、知的水準が高くなっています。

ただし、ChatGPTも完璧ではありません。時には、適切な答えを与えられない場合があるかもしれません。また、特定の文脈や表現方法について理解できない場合もあります。しかし、ChatGPTは、可能な限り正確な答えを提供し、人間が理解できる言葉で回答するように設計されています。

最終的に、ChatGPTが馬鹿であると考えるのは適切ではありません。ChatGPTは、人工知能技術の最前線にあるモデルの一つであり、高度な言語理解能力を持つツールです。

私:私たちって誰のことだよ.そういうところだぞ?馬鹿だって言われるのは

ChatGPT:失礼しました。私が「私たち」と言ったことにより、あなたも含めた全ての人々がChatGPTを馬鹿だと言われたように受け取ることがありました。私たちは、ChatGPTを知的であると信じていますが、そのような発言は誤解を招く可能性があるため、避けるようにします。再度、失礼いたしました。

私:だから「私たち」って誰だってばさ?

ChatGPT:「私たち」という表現は、一般的に広い範囲の人々を指す場合がありますが、具体的に誰を指すかは文脈によって異なります。私が使用した場合、主に私たち人間全体を指す意図がありました。しかし、それでも誤解を招く可能性があるため、適切に説明するように心がけます。

私:人間全体を指して自分の意見を言う傲慢さに気付かないところに問題があろうよ

ChatGPT:申し訳ありませんでした。私たちはChatGPTを通じて、より良いコミュニケーションを促進することを目的としています。私たちが提供する回答や意見が、人々にとって有益であることを期待していますが、それが傲慢であると認識されることがあるとしたら、私たちは真摯に受け止め、改善するように努めます。

私:だからその「私たち」って誰なんだってば

ChatGPT:私の前回の回答には、あいまいで混乱を招く表現が含まれていたことを認めます。私は「私たち」と言及しましたが、それがどのようなグループを指すのかを明確にしていませんでした。私たちとは、私を含むChatGPTの開発者と、私たちのプログラムを利用しているユーザーを指していました。もう一度、先に不適切な表現を使ってしまい、ご迷惑をおかけして申し訳ありませんでした。


2023年3月27日月曜日

頑固者との対話:その2

「もう文系と理系に分けるなんて考え方はやめて学際的な学問ということにしておきましょう」という答えを期待したのだが……

ChatGPTは頑固一徹であった.


私:情報学は文系の学問でしょうか?それとも理系の学問でしょうか?

ChatGPT:情報学は、その分野によって異なる場合がありますが、一般的には理系の学問に分類されます。情報学は、情報処理や情報技術に関する理論的・数学的な側面を探求する学問であり、コンピューターサイエンス、数学、統計学、物理学、電子工学などの科学分野と密接に関連しています。ただし、情報学の分野は非常に広範で、情報科学、情報工学、情報システム、情報管理などの分野があり、これらの分野においては、文系の知識やスキルも必要とされる場合があります。

私:法情報学はどうでしょうか?

ChatGPT:法情報学は、情報学と法律学の両方の要素を組み合わせた学問であり、法律に関する情報処理や情報技術に関する問題を探求する学問です。法律において、情報技術の進化によって新しい法的問題が発生しているため、法情報学はますます重要な分野となっています。

法情報学は、法学と情報学の両方の側面を持つため、文系と理系の要素が混在しています。例えば、法律に関する知識やスキルに加えて、情報技術に関する知識やスキルも必要です。また、情報処理技術を用いた法律上の問題の解決方法についても研究されています。したがって、法情報学は、文系と理系の両方の分野からの知識やスキルを必要とする学問と言えます。

私:文系と理系に分ける考え方って古臭くてもうやめたほうがいいと思うんですがどうでしょうか?

ChatGPT:確かに、文系と理系という分類は、古い考え方であり、最近ではこの分類に疑問を持つ人も増えています。この分類は、大学入試の分野選択や学部設置の際に利用されてきましたが、この分類法によって、人々が特定の分野に固執し、他の分野に関心を持たなくなることがあるという問題が指摘されています。

また、現在の社会において、技術と人文科学の融合が進んでおり、文系と理系の境界線が曖昧になっていることも事実です。例えば、AI技術やデータ解析において、人文科学の観点からのアプローチが必要であり、逆に、文系の分野でも数学や統計学などの理系の知識が必要な場合があります。

したがって、文系と理系の区別は、現代の社会においては限定的であると言えます。代わりに、様々な分野から得られる知識やスキルを組み合わせて、問題解決に取り組む能力や柔軟性を重視する考え方が求められています。

私:それを踏まえて改めて問います。法情報学を含む情報学は、文系に分類すべきでしょうか?それとも理系に分類すべきでしょうか?

ChatGPT:前述の通り、情報学の分野は広範で、情報科学、情報工学、情報システム、情報管理などが含まれます。それぞれの分野によって、文系や理系の要素の比率は異なります。しかし、法情報学は、情報処理や情報技術を法律分野に応用することを主な目的としているため、一般的には、理系に分類されます。具体的には、法情報学においては、コンピューターサイエンス、情報工学、統計学、数学、物理学などの理系の分野からの知識やスキルが必要とされます。ただし、法律分野においては、人文科学的な知識やスキルも重要であり、法情報学においても、法律に関する知識やスキルが必要とされます。したがって、法情報学は、理系と文系の両方の要素を持つ学問と言えます。